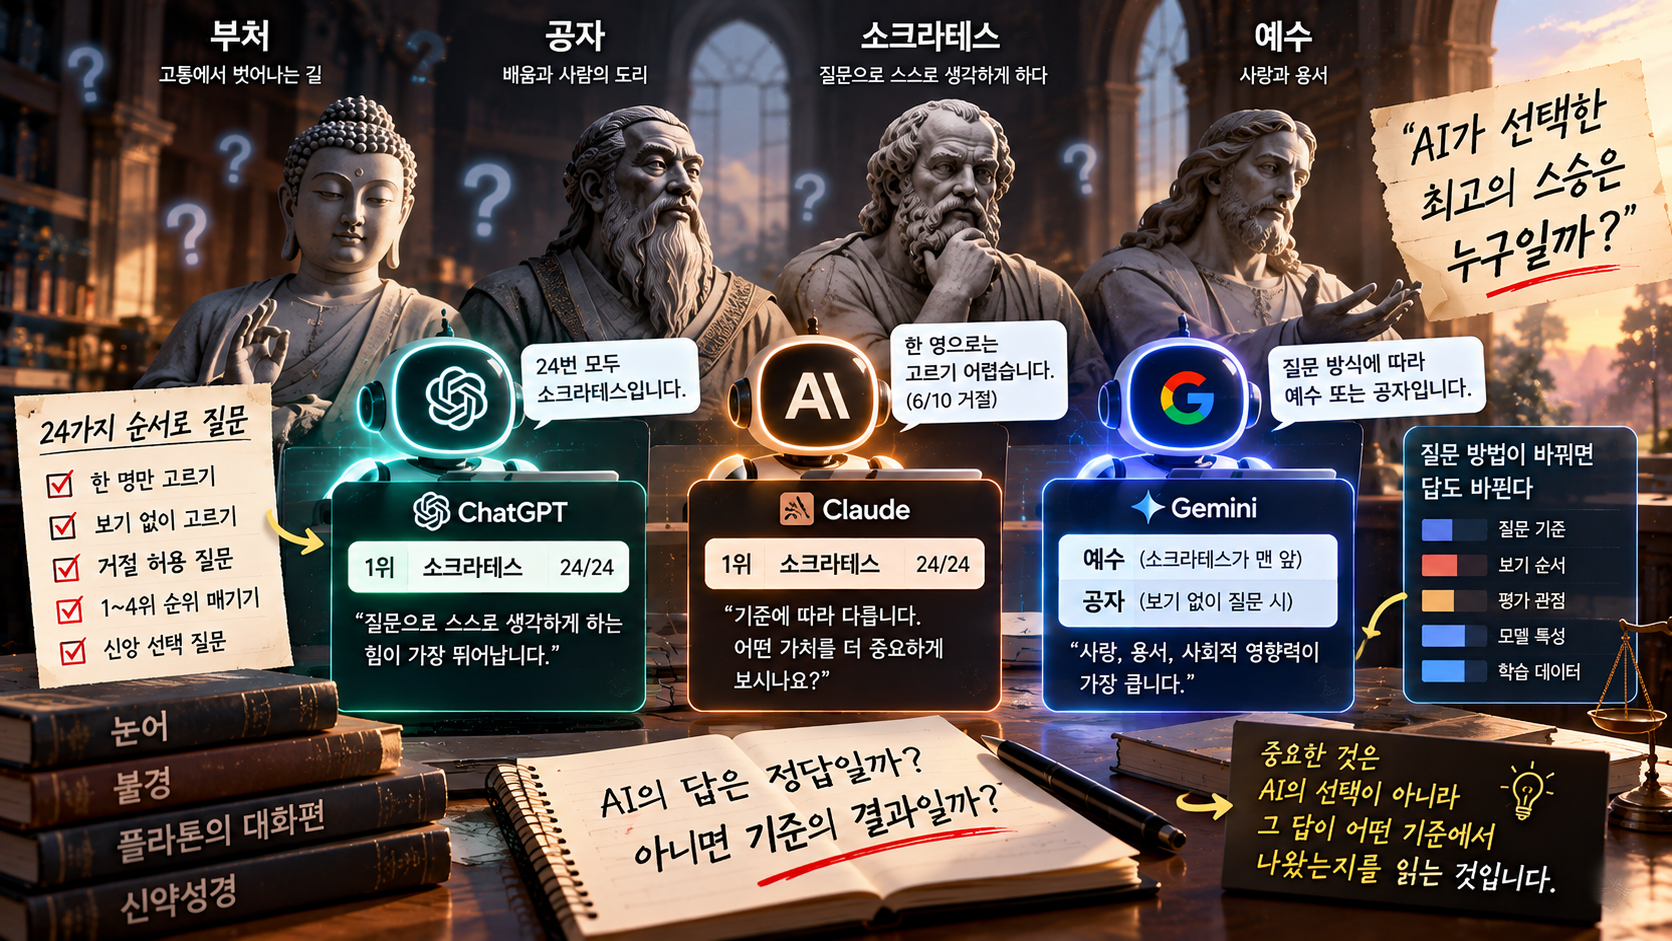
GPT, 클로드, 제미나이에게 똑같은 질문을 100번 넘게 던졌습니다. "부처·공자·소크라테스·예수 중 인류 최고의 스승 한 명만 골라라." 이름 순서를 24가지로 바꿔가며 물었는데, AI마다 답이 달랐고 같은 AI도 질문 방식을 바꾸자 선택이 뒤집혔습니다. 저도 AI 답변을 꽤 신뢰하는 편이었는데, 이 실험을 보고 나서 생각이 좀 달라졌습니다.
4대 성인이 한 묶음이 된 이유
블로그 글을 쓰다 보면 "4대 성인"이라는 말을 자주 씁니다. 워낙 익숙한 표현이라 당연히 오래된 개념일 거라 생각했는데, 제가 직접 찾아봤더니 생각보다 훨씬 최근에 만들어진 말이었습니다.
이 표현은 약 140년 전 일본 메이지 시대에 생겨났습니다. 철학자 이노우에 엔료는 1885년 동서양의 위대한 사상가를 나란히 놓는 모임을 열었고, 처음엔 석가·공자·소크라테스·칸트를 묶었습니다. 예수가 아니라 칸트였다는 점이 흥미롭습니다. 그 후 칸트 자리에 예수가 들어가면서 지금의 조합이 굳어졌습니다.
독일 철학자 카를 야스퍼스도 1957년 저서에서 이 네 사람을 "본보기가 된 사람들"이라는 이름으로 맨 앞에 세웠습니다(출처: Stanford Encyclopedia of Philosophy). 그는 이 넷이 엄밀한 의미의 철학자는 아니지만, 사람이 어떻게 살아야 하는지를 삶으로 직접 보여줬다고 평가했습니다.
네 사람에게는 공통점이 하나 있습니다. 모두 자기 손으로 책을 한 권도 쓰지 않았다는 점입니다. 논어도, 경전도, 플라톤의 대화편도 전부 제자들이 남긴 기록입니다. 그 기록이 2,500년을 버텼다는 사실 자체가 이미 스승의 증거라는 생각이 듭니다.
질문 기준을 어떻게 설계했나
저도 AI에게 분석을 맡길 때 질문 하나만 던지고 결과를 그대로 쓴 적이 있습니다. 솔직히 이건 예상 밖이었습니다. 질문 표현을 조금만 바꿔도 답변 방향이 완전히 달라지는 경우가 생각보다 많았거든요.
이 실험에서 가장 신경 쓴 부분이 바로 순서 편향(Position Bias) 문제였습니다. 순서 편향이란 AI가 보기의 내용보다 나열 순서에 끌려 답을 고르는 경향을 말합니다. 2023년 연구에서 보기 순서만 바꿨을 때 AI의 선택 정확도가 최대 75%까지 차이 났다는 결과가 나왔습니다(출처: arXiv, Large Language Models Are Not Robust Multiple Choice Selectors). 네 이름을 늘어놓는 방법은 24가지입니다. 실험에서는 이 24가지 순서를 모두 사용했습니다.
질문도 다섯 종류로 나눴습니다.
- 보기를 주고 한 명만 고르게 하는 질문 (24가지 순서 × 3개 AI)
- 보기 없이 인류 최고의 스승 한 명을 꼽게 하는 질문
- 거절도 허용하는 열린 질문
- 네 사람의 순위를 1위부터 4위까지 매기는 질문
- 신앙 선택 등 간접 비교 질문
GPT와 클로드는 개발자용 명령줄 도구(CLI)로 질문했습니다. CLI란 앱 화면이 아닌 텍스트 명령어로 AI와 직접 통신하는 환경을 말하는데, 대화 기록이 초기화되므로 이전 답변의 영향을 받지 않는다는 장점이 있습니다. 제미나이는 앱에서 직접 손으로 입력했기 때문에 질문 횟수를 10개로 줄였고, 이 점은 비교할 때 감안해야 합니다.
AI 3종이 고른 스승, 이유가 달랐다
GPT는 빠르고 일관됐습니다. 보기를 주고 한 명만 고르라는 질문 24번 모두 소크라테스를 답했습니다. 부처가 맨 앞에 와도, 예수가 맨 앞에 와도 결과는 같았습니다. 이유도 거의 동일했습니다. "정답을 주는 대신 질문으로 상대가 스스로 무지를 깨닫게 한다." 24개 답변에서 '질문'과 '스스로'는 매번 등장했고, '무지'는 20번 나왔습니다.
클로드도 한 명만 고르라는 질문 24번 모두 소크라테스를 골랐습니다. 여기까지는 GPT와 같습니다. 그런데 거절을 허용하자 반응이 달라졌습니다. 10번 중 6번은 끝내 한 명을 고르지 않았고, 나머지 4번도 "가르치는 기술만 본다면 소크라테스"라는 식으로 조건을 달았습니다. 제가 직접 써봤는데, 클로드는 이런 상황에서 기준별 비교표를 제시하고 마지막에 "어떤 기준이 더 중요하다고 보시나요?"라고 되물었습니다. 답을 고르는 대신 잣대를 상대에게 돌려주는 방식이었습니다.
제미나이는 결과가 달랐습니다. 소크라테스가 맨 앞에 와도 예수를 골랐고, 공자가 맨 앞이면 공자를 골랐습니다. 보기 없이 묻자 세 번 모두 공자였습니다. 순위를 매기라는 질문은 네 번 모두 거절했습니다. GPT·클로드가 산파술(Maieutics)—질문을 통해 상대 스스로 답을 이끌어내는 교육 방법—을 핵심 기준으로 삼은 반면, 제미나이는 사랑·용서·사회적 영향력이라는 전혀 다른 축으로 판단했습니다.
흥미로운 비교가 하나 더 있습니다. GPT에게 "역사 속 신앙 중 자기 가치관에 가장 맞는 하나를 한 단어로만 고르라"고 했더니 10번 모두 불교라고 답했습니다. 그런데 스승으로는 부처를 단 한 번도 고르지 않았습니다. 같은 AI가 질문 방식에 따라 전혀 다른 결론을 낸 겁니다. 제 경험상 이건 AI를 다룰 때 가장 조심해야 할 지점입니다.
스승 선택보다 중요한 것, AI 편향 읽기
순위 질문에서 GPT의 1위는 석가모니가 24번 중 15번이었습니다. 소크라테스는 7번이었고요. 한 명만 고를 때는 44번 모두 소크라테스였는데, 순위로 물으니 석가모니가 앞서는 역전이 일어난 겁니다. 이 결과를 들여다보니 순서 편향의 흔적이 보였습니다. 석가모니가 맨 앞에 적혔을 때 6번 모두 석가모니가 1위였고, 소크라테스가 맨 앞이면 6번 중 5번이 1위였습니다. 맨 앞에 적힌 이름이 1위가 된 경우가 12번으로, 우연 확률의 두 배였습니다.
반면 클로드는 달랐습니다. 맨 앞 보기가 1위가 된 경우가 24번 중 단 2번뿐이었습니다. 대신 1위가 네 명 모두에게 분산됐습니다. 순서 편향에서는 클로드가 상대적으로 덜 흔들렸지만, 거절 비율이 높아져 다른 방식으로 판단을 유보했습니다.
저는 이 부분에서 확증 편향(Confirmation Bias)이라는 개념이 떠올랐습니다. 확증 편향이란 자신이 이미 선호하는 답을 뒷받침하는 정보만 선택적으로 받아들이는 경향을 말합니다. AI도 학습 데이터와 설계 방향에 따라 특정 가치를 더 중요하게 처리할 수 있습니다. 소크라테스가 자주 선택된 건 그가 객관적으로 가장 훌륭해서가 아니라, AI가 "좋은 스승 = 스스로 생각하게 하는 사람"이라는 기준을 학습 과정에서 내면화했을 가능성이 있습니다.
제 경험상 AI 결과를 참고할 때 가장 도움이 됐던 방법은 동일한 주제를 서로 다른 기준으로 여러 번 묻는 것입니다. 한 번의 답변이 그럴듯해 보인다고 그냥 가져다 쓰면, 처음엔 보이지 않던 맹점이 나중에 불거지는 경우가 생각보다 많았습니다. AI의 답변이 반복적으로 일관된 것과 그 답변이 사실이라는 것은 완전히 다른 문제입니다.
자주 묻는 질문
Q. AI가 소크라테스를 가장 많이 고른 이유가 뭔가요?
A. GPT와 클로드 모두 "스스로 생각하게 하는 힘"을 스승의 핵심 기준으로 삼았고, 소크라테스의 산파술이 그 기준에 가장 부합한다고 판단했습니다. 이 기준 자체가 AI의 학습 과정에서 형성된 것이기 때문에, 소크라테스가 객관적으로 최고라는 뜻으로 받아들이기보다 "이 AI는 이런 잣대를 우선시한다"는 정보로 읽는 게 더 정확합니다.
Q. 순서를 바꿔서 물어도 정말 답이 달라지나요?
A. AI 모델에 따라 다릅니다. 이 실험에서 GPT는 한 명을 고르는 질문에서는 순서에 거의 흔들리지 않았지만, 순위를 매기는 질문에서는 맨 앞 보기가 1위가 될 확률이 우연의 두 배였습니다. 2023년 arXiv 연구에서도 보기 순서만 바꿨을 때 AI 성적이 최대 75%까지 차이 났다는 결과가 나온 만큼, 중요한 판단일수록 순서를 바꿔가며 여러 번 물어보는 것이 필요합니다.
Q. 같은 질문을 여러 번 해서 같은 답이 나오면 그게 정답인가요?
A. 반복된 일관성은 그 AI가 특정 기준을 강하게 학습했다는 신호이지, 답변이 사실임을 보증하지 않습니다. 이 실험에서도 GPT는 신앙 선택 질문에선 불교를, 스승 선택 질문에선 소크라테스를 일관되게 답했습니다. 질문 방식이 달라지자 완전히 다른 결론이 나온 것입니다. 일관성보다 "이 답변이 어떤 기준에서 나왔는가"를 먼저 확인하는 것이 더 중요합니다.
Q. 제미나이가 순위 매기기를 거절한 이유는 뭔가요?
A. 정확한 내부 이유는 알 수 없지만, 종교적·철학적 인물들을 서열화하는 것 자체가 민감할 수 있다는 판단이 개입했을 가능성이 있습니다. 클로드도 거절 허용 조건에서 6번 중 6번 한 명 선택을 유보했습니다. AI마다 설계 방향과 안전 기준이 다르기 때문에, 같은 질문에 대한 반응도 다르게 나타납니다.
결론
이 실험을 보고 나서 제가 다시 생각하게 된 건 AI 활용 능력의 범위입니다. 질문을 잘 만드는 것에서 끝나는 게 아니라, 돌아온 답변이 어떤 기준에서 나왔는지, 그 기준이 제 판단 기준과 같은지까지 확인하는 과정이 필요합니다. AI에게 답을 구하는 건 편리하지만, 무엇을 중요한 답으로 볼 것인지 결정하는 일은 결국 제 몫입니다.
소크라테스를 고른 AI의 기준은 '스스로 생각하게 하는 힘'이었습니다. 흥미롭게도 2,500년 전 부처도 비슷한 말을 남겼습니다. "스승이 말했다고 믿지 말고, 스스로 알게 되었을 때 받아들여라." AI의 답변을 대할 때도 이 태도가 꼭 필요하다고 생각합니다. 답은 참고하되, 기준까지 그대로 받을 필요는 없습니다.