바둑 기사가 AI를 이기는 세상이 왔습니다. 그것도 AI를 완벽히 이해해서가 아니라, 열 수 중 세 수만 이해한 채로요. 제가 이 이야기를 처음 들었을 때 든 생각은 단 하나였습니다. "그럼 나는 지금 뭘 배워야 하는 거지?" AI가 2주 간격으로 새 모델을 쏟아내는 지금, 불안감보다 먼저 필요한 건 방향감각입니다.
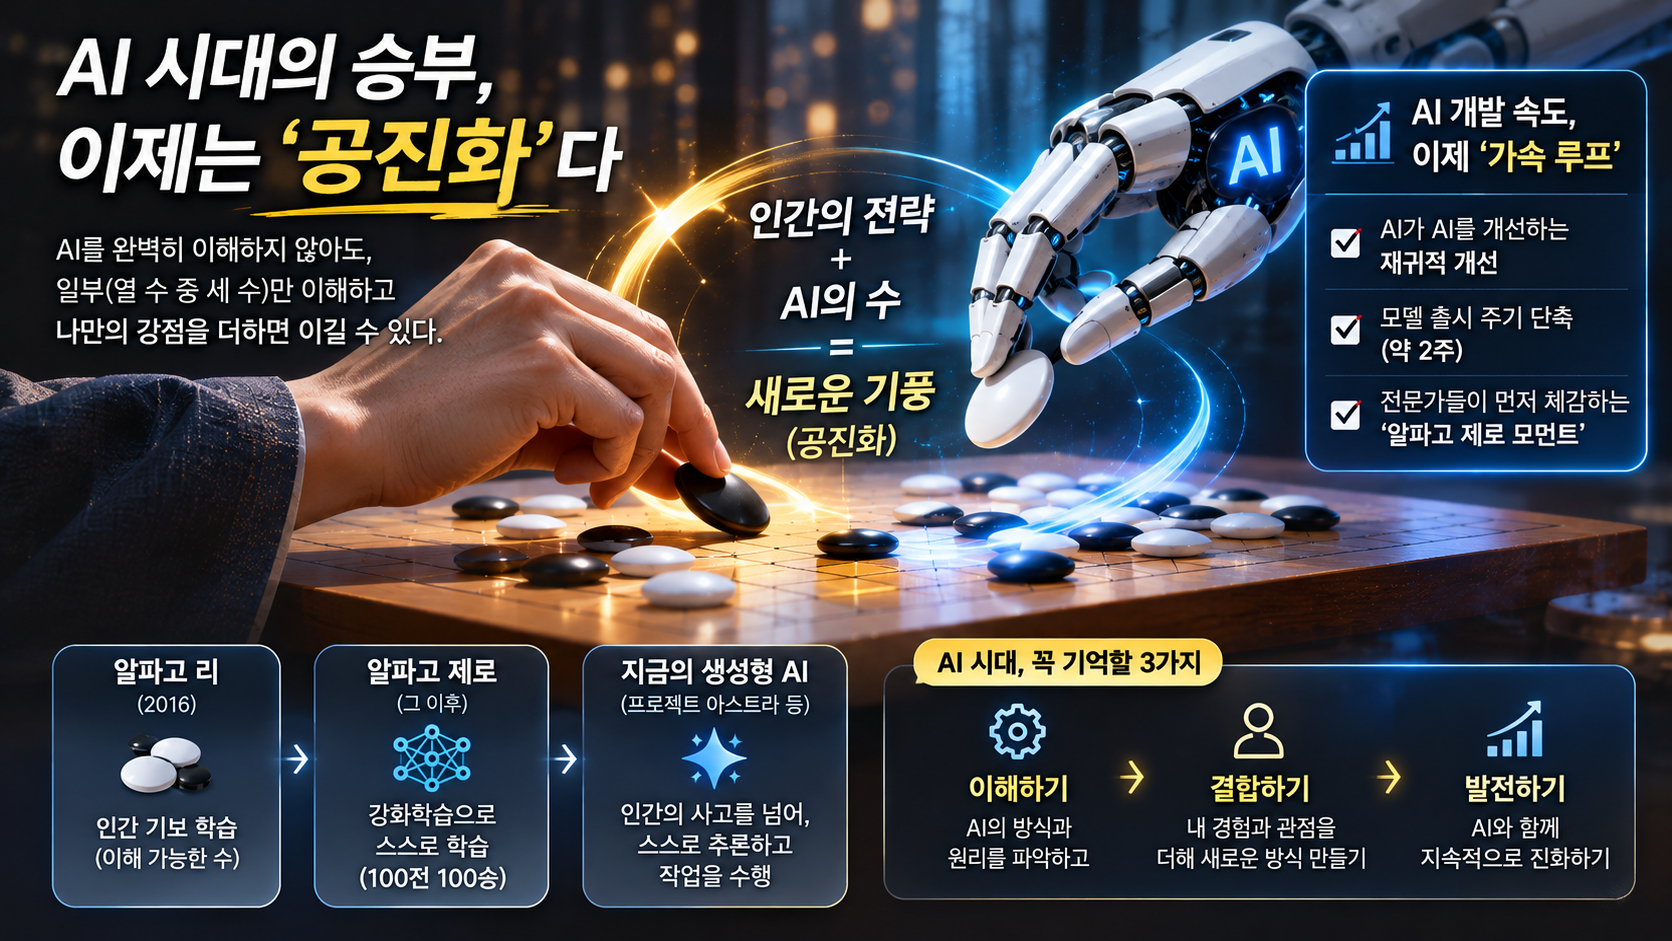
알파고 제로 모먼트가 생성형 AI에도 왔다
2016년 알파고가 이세돌 9단을 이겼을 때 전 세계가 떠들썩했습니다. 그런데 정작 바둑 기사들을 진짜로 뒤흔든 건 그다음에 나온 알파고 제로였습니다. 알파고 제로(AlphaGo Zero)란 인간의 기보를 한 줄도 학습하지 않고, AI끼리 강화학습(Reinforcement Learning)만으로 바둑 규칙을 스스로 터득한 모델입니다. 여기서 강화학습이란 정답을 미리 알려주지 않고 수많은 시행착오를 통해 스스로 최적의 행동을 찾아가는 학습 방식을 말합니다. 이 알파고 제로가 기보 기반의 알파고 리(AlphaGo Lee)를 상대로 100전 100승을 기록했습니다.
이세돌 9단은 알파고 리의 수는 나중에 복기해보면 이해가 됐다고 했습니다. 인간의 방식으로 만들어진 AI니까 납득이 됐던 거죠. 그런데 알파고 제로의 수는 아무리 들여다봐도 왜 저기 뒀는지를 모르겠다고 했습니다. 그게 멘탈 붕괴로 이어졌고, 결국 은퇴로 이어졌다는 이야기를 들으면서 저도 뭔가 서늘한 느낌이 들었습니다.
지금 생성형 AI, 특히 최근 공개된 프로젝트 아스트라(Project Astra)가 딱 그 자리에 와 있다는 생각이 듭니다. 일반 사용자보다는 해당 분야 전문가들이 먼저 놀라는 AI. 타임지가 표지에 'AI 티핑 포인트(Tipping Point)'라는 단어를 올린 것도 그냥 나온 말이 아닙니다. 티핑 포인트란 작은 변화들이 쌓이다가 어느 순간 돌이킬 수 없는 방향으로 급격히 전환되는 임계점을 의미합니다(출처: TIME Magazine).
AI가 AI를 만드는 재귀적 개선의 시대
제미나이(Gemini)의 새 모델이 2주 간격으로 연속 출시되고 있다는 소식을 처음 접했을 때, 솔직히 이건 좀 예상 밖이었습니다. 핵심 인력이 대거 이탈한 조직에서 어떻게 이런 속도가 나오지 싶었거든요. 그런데 그 이유가 재귀적 개선(Recursive Self-Improvement) 때문이라는 걸 알고 나서 생각이 바뀌었습니다.
재귀적 개선이란 AI가 스스로 다음 세대 AI를 설계하고 개선하는 데 점점 더 깊이 관여하는 방식입니다. 쉽게 말해, 사람이 줄고 AI가 AI를 만드는 루프가 돌아가기 시작한 겁니다. 구글은 이 방식을 다른 빅테크보다 적극적으로 차용하고 있다고 알려져 있고, 자체 데이터 센터 인프라를 보유하고 있어 연산 비용 측면에서도 구조적 우위가 있습니다. 오픈AI나 앤트로픽(Anthropic)이 클라우드를 임차해서 쓰는 것과 대비되는 부분이죠.
제가 직접 여러 AI 모델을 병렬로 써보면서 느낀 건, 특정 모델 하나가 압도적으로 좋은 시기가 점점 짧아지고 있다는 점입니다. 몇 달 전엔 클로드(Claude)가 문서 작성에서 확연히 앞섰는데, 지금은 다시 비교해봐야 할 정도로 격차가 줄었습니다. 이런 상황에서 한 모델에만 의존하는 건 오히려 비효율적이라는 걸 몸으로 배웠습니다.
- 오픈AI, 앤트로픽: 외부 클라우드 컴퓨팅 임차 방식으로 운영
- 구글 딥마인드: 자체 데이터 센터 보유, 재귀적 개선 루프 적극 적용
- 그록(Grok): 사용자에게 거의 무제한에 가까운 토큰 제공으로 사용자층 확대 중
공진화, AI 시대에 살아남는 사람들의 공통점
신진서 9단이 알파고를 이길 수 있다고 말하는 이유가 인상적이었습니다. 알파고 제로가 공개되고 바둑계에 AI 연구 바람이 불었을 때, 두 가지 유형의 기사가 생겼다고 합니다. 기존의 수를 고집한 기사와, AI의 수를 연구하기 시작한 기사. 신진서 9단은 후자였고, 7~8년을 연구한 끝에 AI의 10수 가운데 세 수 정도를 이해하는 수준에 이르렀습니다.
여기서 흥미로운 변화가 생겼습니다. AI의 수를 어느 정도 이해한 다음, 본인의 원래 기풍을 다시 그 위에 얹었더니 AI가 두는 수와 조금씩 다른 새로운 화풍이 만들어지기 시작한 겁니다. 이걸 공진화(Co-evolution)라고 표현할 수 있습니다. 공진화란 서로 다른 두 개체가 상호작용하며 함께 진화하는 현상을 말합니다. AI와 인간이 각자의 방식을 고집하는 게 아니라, 서로 영향을 주고받으며 기존에 없던 제3의 방식을 만들어가는 것이죠(출처: Google DeepMind Research).
제가 AI로 글을 쓰거나 자료를 정리할 때도 비슷한 경험을 합니다. 처음엔 AI가 내놓은 결과를 그대로 쓰려다가 뭔가 어색한 느낌에 계속 손을 댔습니다. 그러다 보니 AI가 잡아준 구조 위에 제 관점과 경험이 얹혔을 때 오히려 더 나은 결과가 나왔습니다. AI를 내 방식에 끼워 맞추는 게 아니라, AI의 방식을 먼저 이해하려 한 다음 제 것을 더하는 순서가 맞더라는 걸 그때 느꼈습니다.
속도 조절론과 불안 마케팅, 사실 같은 구조다
앤트로픽과 오픈AI가 AI 속도 조절론을 꺼낼 때마다 저는 죄수의 딜레마(Prisoner's Dilemma)가 먼저 떠오릅니다. 죄수의 딜레마란 두 당사자 모두 협력하면 최선의 결과를 얻을 수 있지만, 상대가 배신할까 봐 결국 둘 다 배신을 선택하게 되는 구조를 말합니다. 내가 속도를 늦춰도 상대가 안 늦추면 혼자 뒤처지는 상황이니까요. 그래서 속도 조절 논의는 "다 같이 멈추자"가 아니라 현실적으로는 "가이드라인을 만들자" 쪽으로 수렴할 가능성이 높습니다.
오픈AI와 앤트로픽이 기업공개(IPO)를 준비하고 있다는 점도 빼놓을 수 없습니다. 상장을 위해서는 컴플라이언스(Compliance), 즉 규정 준수 체계와 감사 시스템이 반드시 필요합니다. 안전성 논의가 순수한 윤리 문제이기도 하지만, 동시에 상장 요건을 갖추기 위한 구조적 과정이기도 한 셈입니다. 저는 이게 오히려 AI 시장이 소수 스타트업의 도박판에서 검증된 메이저 시장으로 안착하는 신호라고 봅니다.
그리고 이 구조는 우리가 자녀 교육을 대할 때의 불안 마케팅과 놀라울 정도로 닮아 있습니다. 빅데이터 전문가, 4차 산업혁명 전문가, AI 전문가. 제가 직접 겪어보니 키워드가 바뀔 때마다 학부모들의 질문은 한결같았습니다. "이거 공부 안 시키면 뒤처지나요?" 그런데 15년을 데이터 분석과 인사이트 도출이라는 같은 일을 해온 입장에서 보면, 키워드는 바뀌었어도 본질은 바뀐 적이 없었습니다. AI를 모르면 위기라는 말보다, 아이가 뭘 좋아하는지 찾아서 깊게 파게 해주는 것이 훨씬 더 오래가는 경쟁력입니다.
자주 묻는 질문
Q. AI 모델이 자꾸 바뀌는데 어떤 걸 써야 하나요?
A. 제 경우엔 하나만 고집하는 것보다 목적에 따라 두세 가지를 병렬로 쓰는 방식이 더 잘 맞았습니다. 예를 들어 자료 정리는 클로드, 초안 작성은 ChatGPT 식으로 역할을 나눠두면 어느 모델이 업데이트되어도 흔들리지 않습니다. 모델 성능 순위는 수개월마다 바뀌기 때문에, 특정 모델에 완전히 의존하는 구조는 생각보다 리스크가 큽니다.
Q. 알파고 제로와 요즘 생성형 AI가 어떻게 연결되나요?
A. 알파고 제로는 인간의 지식 없이 강화학습만으로 기존 AI를 압도했습니다. 지금의 프로젝트 아스트라처럼 최신 생성형 AI도 인간이 설계한 사고 흐름에서 벗어나 스스로 추론 과정을 줄이거나 재구성하기 시작했습니다. 일반 사용자보다 전문가들이 먼저 체감하는 이 변화가 알파고 제로 모먼트와 닮아 있다는 겁니다.
Q. AI 시대에 자녀 교육, 뭘 준비시켜야 하나요?
A. 제가 강의 현장에서 15년간 받아온 질문인데, 솔직히 특정 학과나 기술보다 아이가 뭘 좋아하는지 찾아주는 것이 가장 오래가는 답이었습니다. AI 관련 학과 이름은 몇 년마다 바뀌지만, 자기가 좋아하는 분야를 깊게 파는 능력은 어떤 키워드 시대에도 통합니다. 코딩이든 AI든 도구를 배우는 것과 그 도구를 왜 쓰는지 스스로 판단하는 능력은 다른 문제입니다.
Q. AI 속도 조절론, 진짜 멈출 수 있을까요?
A. 제 생각엔 현실적으로 전면 중단은 어렵습니다. 죄수의 딜레마처럼 한 곳이 멈추면 다른 곳이 치고 나오는 구조이기 때문입니다. 실제로 빅테크 간 논의는 "멈추자"보다는 "규정을 만들자"는 방향으로 흘러가고 있고, 기업공개를 앞둔 기업들에게 컴플라이언스 체계 구축은 어차피 필요한 수순입니다. 결과적으로 속도 조절보다는 책임 기준이 명확해지는 방향이 될 가능성이 높습니다.
결론
신진서 9단이 알파고를 이길 수 있다고 말하는 배경에는 10년 가까운 연구와, AI의 수를 자기 것으로 소화해낸 과정이 있습니다. 제가 이 이야기에서 가장 오래 생각하게 된 부분은 기술의 완벽한 이해가 아니라 부분적 이해 위에 자기 관점을 얹는 것이 진짜 경쟁력을 만든다는 점이었습니다.
AI가 새로 나올 때마다 불안해하기보다는, 지금 쓰는 도구를 조금 더 깊이 이해하고 제 판단을 더하는 연습이 훨씬 실용적입니다. AI의 답변이 그럴듯해 보여도 사실관계를 확인하고, 최종 판단은 제가 내리는 습관. 그게 이 시대에 가장 오래가는 경쟁력이라고 생각합니다.